- DDR
1 核心概念快速区分
- SRAM 和 DRAM 是两种根本不同的技术。
- SDRAM 和 DDR 都是 DRAM 技术的子类和演进版本。
2 对比表格
| 特性 | SRAM (静态随机存取存储器) | DRAM (动态随机存取存储器) | SDRAM (同步动态随机存取存储器) | DDR SDRAM (双倍数据速率同步动态随机存取存储器) |
|---|---|---|---|---|
| 全称 | Static Random-Access Memory | Dynamic Random-Access Memory | Synchronous Dynamic Random-Access Memory | Double Data Rate Synchronous Dynamic Random-Access Memory |
| 本质 | 一种内存技术 | 一种内存技术 | DRAM 的一种(子类) | SDRAM 的一种(子类/演进) |
| 工作原理 | 使用触发器(Flip-Flop) 存储数据,只要通电数据就永久保持。 | 使用晶体管和电容存储数据,电容会漏电,需要定期刷新。 | 与系统时钟同步的 DRAM。所有操作按时钟周期步进,效率更高。 | 在 SDRAM 基础上,在一个时钟周期的上升沿和下降沿各传输一次数据,速度翻倍。 |
| 速度 | 非常快 | 慢 | 比传统异步 DRAM 快 | 比 SDRAM 快一倍(同频率下) |
| 功耗 | 较高(始终通电) | 较低(但需要刷新电路) | 较低 | 较低 |
| 集成度/容量 | 低(结构复杂,1 个比特需 6 个晶体管) | 高(结构简单,1 个比特只需 1 个晶体管+1 个电容) | 高 | 高 |
| 成本 | 高 | 低 | 低 | 低 |
| 主要用途 | CPU 缓存(L1, L2, L3 Cache) | 传统内存条(已被 SDRAM 淘汰)、显卡显存(GDDR 基于 DDR 技术) | 旧式内存条(如 Pentium III 时代,SDR SDRAM) | 现代内存条(如 DDR3, DDR4, DDR5) |
| 是否需要刷新 | 否 | 是 | 是 | 是 |
| 引脚(Pin) | 无需关注 | 无需关注 | 168 pin(通常有两个缺口) | 184 pin 或更多(通常只有一个缺口) |
3. SDRAM 到 DDR3 的演变
3.1 内存代际对比图
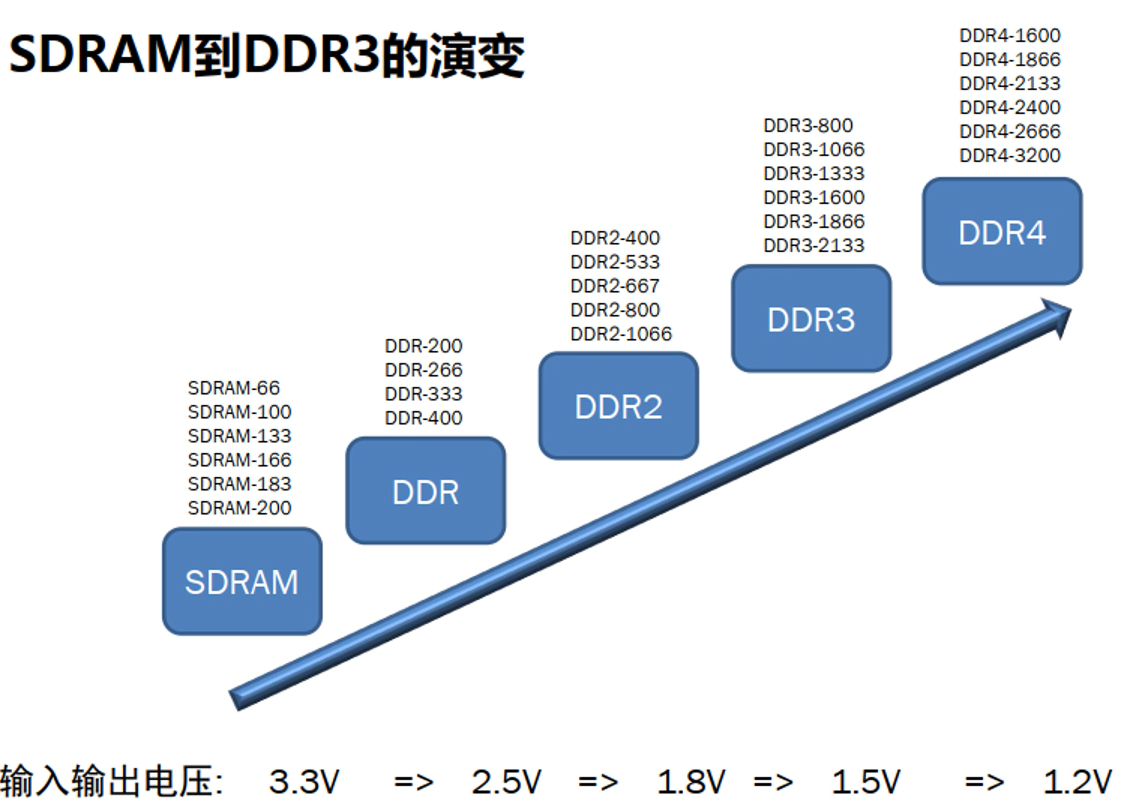
3.2 各代内存对比
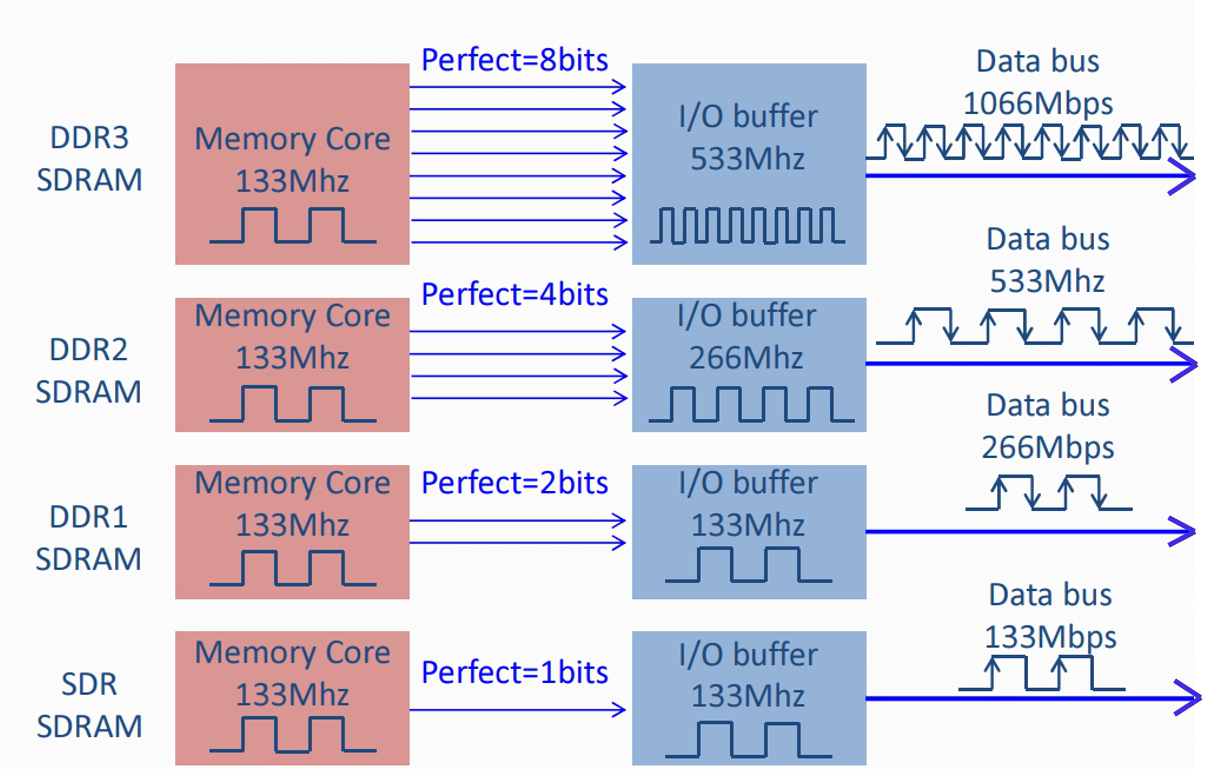
这张图比较了不同代内存(SDR、DDR1、DDR2、DDR3)在同一 memory core 时钟下,如何通过 I/O 缓冲和传输方式提高数据总线有效带宽的原理。
- 左侧红色方块“Memory Core 133MHz”:假定所有代的内存内部核心时钟都为 133 MHz(即芯片内部处理/寻址的时钟频率相同)。
- 中间蓝色方块“I/O buffer”:表示外部 I/O 缓冲/接口电路,它们的工作频率随代际提高而增加(或用更高的技术实现更高的有效数据率)。
- 右侧箭头与波形表示数据总线上的实际传输速率(单位通常是 Mbps 或 MT/s)。
各代对比(从下到上)
- SDR SDRAM(单倍数据速率)
- Memory core: 133 MHz
- I/O buffer: 133 MHz
- 数据总线:在时钟上沿或下沿传输一次(single data rate),因此数据率与时钟相同:133 Mbps(或 133 MT/s)。
- 图中波形显示每个时钟周期只传输一次数据脉冲。
- DDR1 SDRAM(双倍数据速率)
- Memory core: 133 MHz(仍然)
- I/O buffer: 133 MHz(但接口在上/下沿同时采样)
- 数据总线:DDR(Double Data Rate)在时钟上沿与下沿都传输数据,所以有效数据率翻倍:266 Mbps。
- 图中“Perfect = 2 bits” 表示每个时钟周期等效传输 2 比特(或 2 次数据项)。
- DDR2 SDRAM
- Memory core: 133 MHz
- I/O buffer: 266 MHz(或内部使用更高频率的 I/O 策略)
- 数据总线:通过更快的 I/O 与内部预取(pre‑fetch)技术,每个时钟周期等效传输更多数据,图中标注“Perfect = 4 bits”,因此有效数据率为 533 Mbps(即 133 MHz × 4)。
- DDR2 通过提高 I/O 缓冲运行频率并在 IO 端使用更复杂驱动实现比 DDR1 更高的峰值带宽。
- DDR3 SDRAM
- Memory core: 133 MHz
- I/O buffer: 533 MHz(更高的 I/O 频率)
- 数据总线:图中“Perfect = 8 bits” 表示每个核心时钟周期等效传输 8 个数据单元(通过更高的预取和更高 I/O 速率实现),因此有效数据率达到 1066 Mbps(或称 1066 MT/s)。
- DDR3 在相同核心频率下通过 8n prefetch 与更快的外部速率把带宽大幅提高。
关键概念解释
- prefetch(预取):内存内部在一次访问中并行准备多个数据位(例如 2n / 4n / 8n prefetch),使 I/O 可以一次连续发送更多数据而不必提高内部核心频率。
- I/O buffer 频率:外部接口工作频率通常高于或等于核心频率的倍数,从而在每个核心周期内产生多个外部数据传输时钟。
- DDR(双倍数据率):在时钟上沿和下沿传输,等效翻倍数据率。
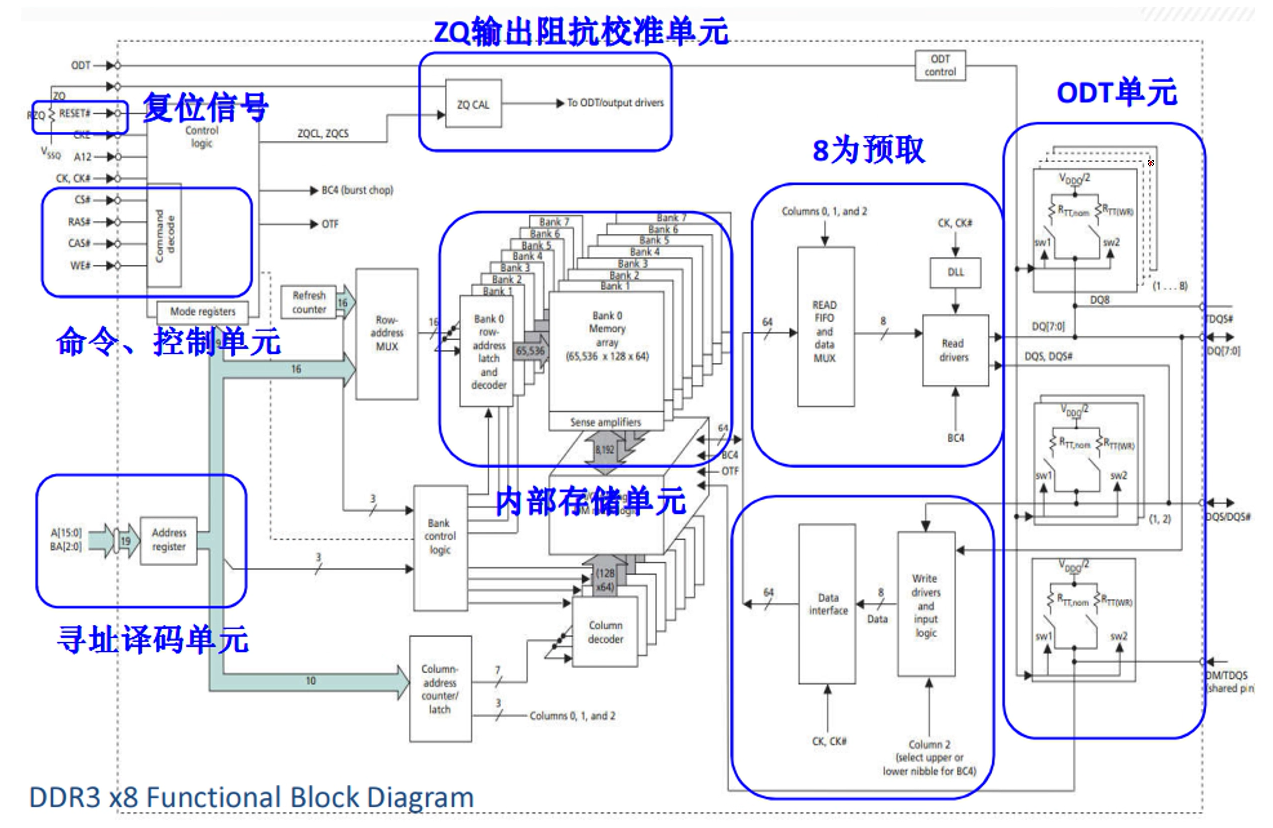
4 DDR3 SDRAM 框图
5 信号分类
| 组别 | 信号 | 说明 |
|---|---|---|
| 时钟 | CLK/CLK# | 时钟差分信号 |
| 地址/命令 | ADDR | 地址信号,行列复用 |
| BA | Bank地址 | |
| RAS#/CAS#/WE# | 行地址选通/列地址选通/写使能 | |
| 控制 | CKE/CS# | 时钟使能/片选信号 |
| 数据组 | DQ | 数据信号 |
| DM | 数据掩码 | |
| 数据选通 | DQS | 数据选通信号 |
5.1 时钟线设计要求
- 总长度 < 4000 mil(DDR3)
- 误差 < 10 mil
- 需有完整地平面作为参考,提供低阻抗回流路径
5.2 分组等长需求
- DQ 以 DQS 为标准等长,误差 < 50 mil
- 地址组/命令组/控制组以时钟为标准等长
- 走线间距 > 20 mil
- vref 宽度 > 30 mil
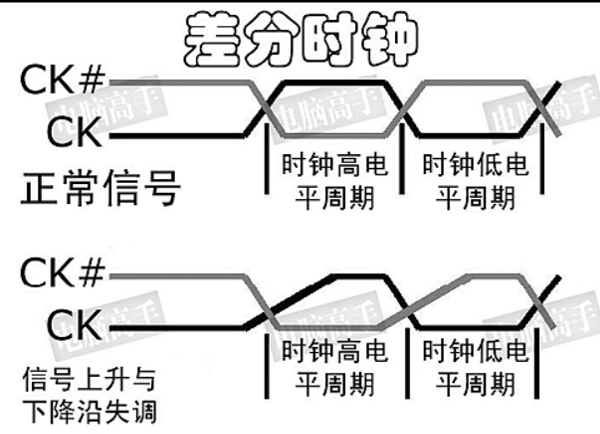
5.3 差分时钟的优势
- CK 与 CK# 抵消上升沿慢等非对称问题
- 提高信号抗干扰能力
6 ZQ 校正功能(DDR3 引入)
1) 背景 — 为什么需要校准阻抗
- 高速内存接口(DDR3)对信号完整性依赖很高,关键之一是接口两端的阻抗(驱动阻抗和终端/上拉下拉阻抗)要与板上传输线的特性阻抗(通常 40Ω、50Ω 等)匹配。
- 如果阻抗不匹配,会产生反射、抖动和幅度变化,影响可靠的数据传输。
- 传统上,终端电阻(如 RTT)和输出驱动阻抗通过板上固定电阻/网络来实现,但这样难以精确匹配器件内部随工艺/电压/温度(PVT)变化的驱动阻抗。
2) ZQ 校正(ZQ Calibration)是什么(核心概念)
- ZQ 校正是 DDR3/DDR3L 规范引入的机制:在 DRAM 内部提供可调的输入/输出阻抗(包括 ODT、输出驱动阻抗等),并通过外部的一个精确电阻(标记为 RZQ,通常 240Ω)作为参考,完成内部阻抗的自动调节与校准。
- 换言之,DRAM 芯片“自校准”其输出/终端阻抗,使其在不同工况下维持接近目标值,从而更精确地匹配板级传输线阻抗,提升信号质量。
3) ZQ 校准能校准哪些阻抗
- On-Die Termination(ODT,芯片内终端电阻),即对读操作接收端/写操作终端的阻抗。
- 输出驱动阻抗(Output driver)——写操作时芯片输出端的驱动强度(上拉/下拉电阻)。
- 上拉(pull-up)和下拉(pull-down)内部等效阻抗(R_TT(PU)、R_TT(PD))等。
4) 校准的工作原理(简化说明)
- 外部在 PCB 上放置一个高精度参考电阻 RZQ(如 240Ω),并把该电阻的一端接到特定的 ZQ 引脚/节点,另一端接地或 VSSQ(规范指定)。
- DRAM 芯片内部有一套测量和调整电路:在校准期间,芯片测量经过内部阻抗网络与外部 RZQ 形成的电压/电流关系,然后通过内部可变元件(比如可编程电阻阵列或开关)调整内部阻抗,直到达到与 RZQ 对应的目标值。
- 校准可以在上电初始化、芯片要求时或定期触发(ZQCL / ZQCS 命令),确保随温度、电压变化仍维持阻抗匹配。
5) 要点解释
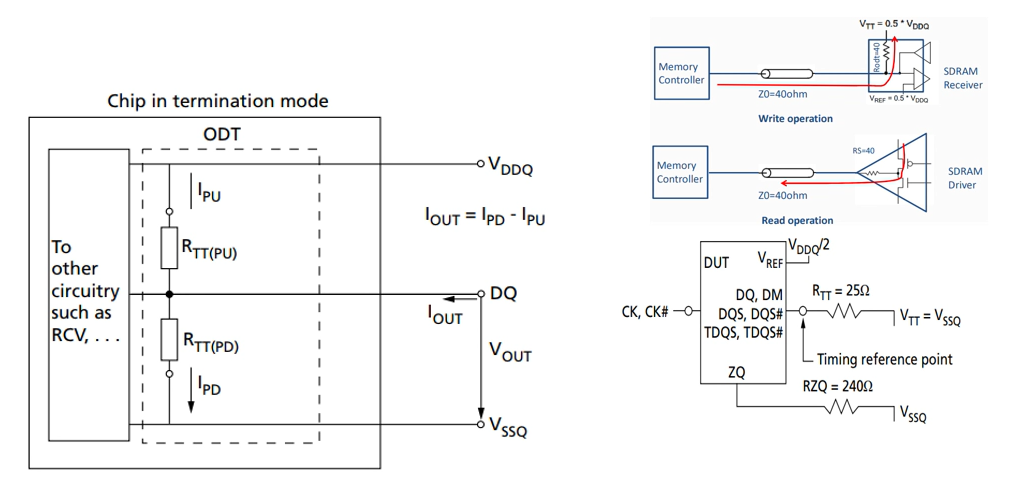
- 左下大图(Chip in termination mode):展示了芯片内的 ODT 电阻由上拉阻抗 R_TT(PU) 和下拉阻抗 R_TT(PD) 组成,并有对应的上拉电流 I_PU 和下拉电流 I_PD。通过 ZQ 调整这些等效电阻,以改变 DQ 线到 VDDQ / VSSQ 的阻抗表现。
- 右上小图(Write/Read operation):说明写操作时 SDRAM 驱动器(driver)对线的影响以及读操作时接收器(receiver)和终端阻抗的作用,强调阻抗匹配对避免反射的重要性。
- 右下小图(ZQ 引脚示意):显示 DUT(device under test)上的 ZQ 引脚与外部 RZQ 的连接,R_TT 被规范为目标比如 25Ω(取决于 ODT 配置),RZQ 标称为 240Ω,给出时序参考点与 VTT/VSSQ 等连接关系。
6) ZQ 校准的优点
- 精度更高:通过内部对参考电阻的动态校准,ODT 和输出阻抗能更准确地匹配板上阻抗。
- 节省板级元件:不需要在每条数据线上放大量的外部匹配元件(可以减少 PCB 空间和 BOM 成本)。
- 抗 PVT:能补偿工艺、电压、温度造成的阻抗漂移,维持长期的信号性能。
- 统一与规范:DDR3 规范定义了 ZQ 的时序与命令(如 ZQCL,ZQCS)以保证互操作性。
7) 使用与实现注意事项
- 必须在 PCB 上放置正确标称值与精度的 RZQ(规范通常要求 240Ω ±1% 等),并把它正确连到 DRAM 的 ZQ 引脚。
- 在内存初始化时按规范进行 ZQCL/ZQCS 命令周期以完成校准;有些系统也建议在温度大幅变化或运行中定期重校准。
- 校准期间 DRAM 的某些功能可能受限(视规范),需在控制器固件/初始化序列中安排好时序。
- 虽然 ZQ 可大幅减少对外部匹配元件的需求,但板级设计仍需按信号完整性(SI)原则进行走线、阻抗控制和电源去耦,ZQ 不是替代良好 PCB 设计的手段,而是补充。
- 不同厂商器件对 ODT 配置(可选的阻值设置)和默认行为可能有所差异,设计时参考具体 DDR3 器件的数据手册。
8) 总结(一句话)
- ZQ 校正通过外部参考电阻让 DDR3 芯片自动校准其内置终端与输出驱动阻抗,从而实现更精确的阻抗匹配、提高信号质量并减少外部匹配元件需求,特别适用于高速、多颗粒的内存系统。
7. 拓扑结构:T 型 vs Fly-by
- 什么是 fly-by 拓扑
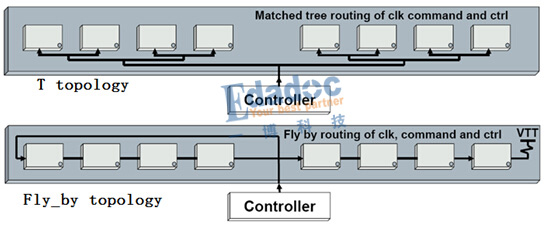
- 在传统点对点(T 型)布线中,内存控制器(Processor/CPU)把地址/命令(ADDR/CMD)、控制信号(CTL)、时钟(CLK)并联分支到每个内存芯片(DIMM 内的每个 DRAM),每个分支长度相同、同时到达(理想情况)。
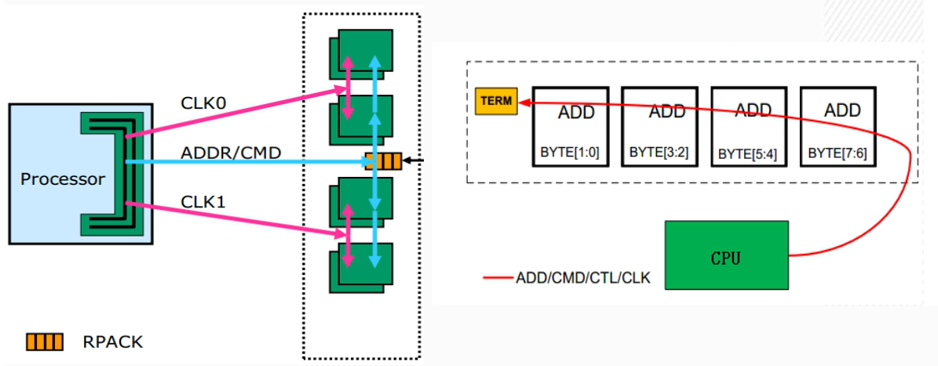
- fly-by 拓扑则采用串联方式:从控制器出发,信号按顺序经过第一个 DRAM、第二个 DRAM……最后到终端(Termination)。图中显示 ADDR/CMD/CTL 信号像一条“链”依次到每颗内存器件,而时钟(CLK)通常也采用类似顺序布线(CLK0、CLK1)。
- fly-by 的实际布局在 DDR3 DIMM 上更容易实现信号完整性和制造可靠性,因此 DDR3 模块普遍采用 fly-by。
- fly-by 的优点
- 信号完整性更好:串联式走线减少了多个分岔点(stub),减小反射和串扰,使高速传输更稳定。
- 在多颗 DRAM 的模块上(颗粒较多或速度高时)比 T 型更可靠。
- fly-by 带来的问题:时序偏移(Skew)
- 因为信号是依次到达各颗器件,ADDR/CMD 到各个 DRAM 的到达时间不同(第一颗最先,最后一颗最晚),这就是所谓的通路延迟差(skew)。
- 尤其是 DQS(数据写入/读取时的局部时钟/数据相位)和系统 CLK 之间会产生偏差:memory 芯片收到控制/时钟信号的时间并不相同,会影响写入/读取的数据对齐。
- 解决方法:终端与 Write Leveling
- 末端匹配(termination):fly-by 需要在链条末端做终端匹配(图中的 TERM),并且通常在 DIMM 上加上 RPACK(串联阻抗等)或末端电阻以保证阻抗连续、减少反射。
- Vtt 电源与匹配电阻:为了末端终端和信号完整性,需增加匹配电阻和 Vtt(终端电压)等引脚与供电。
- Write Leveling(写入校准):DDR3 定义了 write leveling 功能,允许 memory controller 与 DRAM 交互测量和校正 DQS 与 CK(时钟)之间的相位差。通过这个过程,控制器可以为每个 DRAM 片选/字节 lane 调整时序补偿,从而在 fly-by 拓扑带来的 skew 下仍能保证可靠的数据写入。
- 对于颗粒数量较少且速度不高的场合,可以使用 T 拓扑以节省匹配电阻和 Vtt 电源;但当颗粒多或速度高时,仍推荐 fly-by 并做末端匹配与 write leveling。
- 实际设计注意事项(简要)
- 确认所用 Memory controller 是否支持 write leveling(否则 fly-by 会难以校准)。
- 设计板级走线时考虑各颗粒到时钟/命令的延迟与匹配,规划终端电阻和 RPK/RTerm。
- 在低速或少颗粒场景可考虑 T 拓扑以节省硬件成本;在高速或多颗场景优先使用 fly-by 并做相应校准。
留下评论